Американские нейрохирурги из Калифорнийского университета в Сан-Франциско впервые показали, что один мозговой имплант может одновременно расшифровывать и попытку произнести фразу, и попытку сделать жест. Парализованные участники управляли собственным трехмерным аватаром, который выводил их слова на экран и в то же время махал рукой или пожимал плечами. Это важно, потому что живое общение состоит не только из слов, а прежние нейроинтерфейсы умели передавать либо речь, либо движения, но не все сразу. Работа опубликована в журнале Nature Neuroscience.
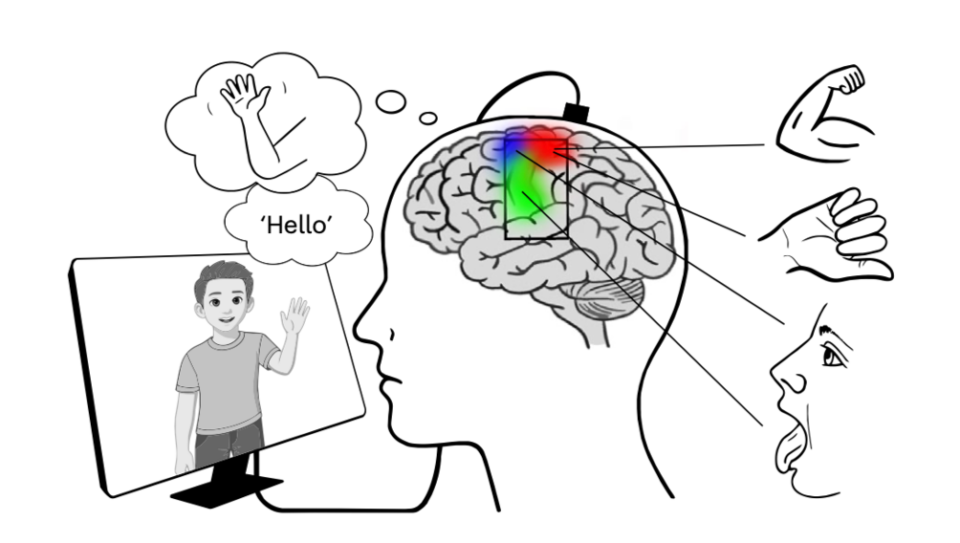
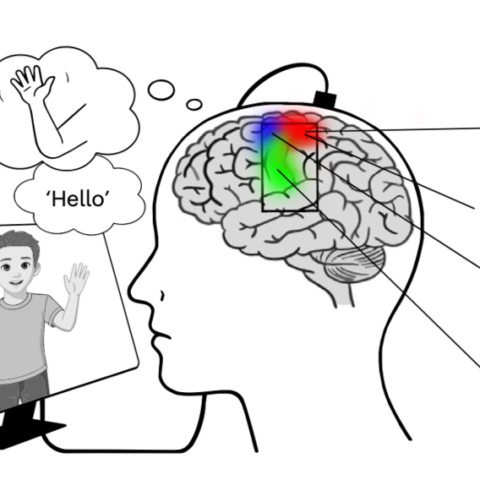
Схема работы импланта. Credit: Brosler et al. / Nature Neuroscience 2026
Инсульт ствола мозга и боковой амиотрофический склероз (БАС) могут лишить человека и речи, и движений. Нейроинтерфейсы, то есть системы, переводящие активность мозга в команды для компьютера, уже умеют возвращать таким людям речь. Например, в 2023 году та же группа ученых научила говорить и менять мимику цифровой аватар женщины, парализованной после инсульта. А в 2025 году эти исследователи создали нейропротез, который превращает попытки речи в голос почти без задержки. Другие команды с помощью нейроинтерфейсов управляли курсором и даже восстанавливали ходьбу. Однако каждую функцию, как правило, расшифровывали отдельно. Недавно ученые также показали, что двигательная кора устроена сложнее классической карты тела, ибо в каждой ее точке в той или иной мере представлено все тело. Из опытов с электродами, вживленными в толщу коры, также было известно, что одновременные действия мешают друг другу – например, попытка говорить ухудшала управление курсором. Как поведет себя запись с поверхности мозга, оставалось неясным.
В новом исследовании участвовали трое добровольцев – мужчина и женщина после инсульта ствола мозга и мужчина с БАС. Каждому на поверхность левого полушария уложили пластину с 253 электродами, которая покрывала двигательную и чувствительную кору. Сначала участники пытались выполнить около 45 разных движений, от моргания и кивка до движений пальцами, губами и языком, а также произнести несколько слов. Затем двое из них (женщина к тому времени выбыла из исследования) учились «произносить» короткие фразы вроде «привет» или «может быть» и одновременно делать жесты. Мужчина с БАС говорил вслух, но неразборчиво, а жесты лишь представлял, второй участник пытался говорить беззвучно. Сигналы мозга разбирали две параллельные нейросети: одна угадывала фразу, другая жест. Речь выводилась текстом, а жест воспроизводил аватар, внешность которого участники выбрали сами.
Одна пластина действительно «видела» почти все тело. Зоны рук, лица и речи располагались на коре в привычном порядке, и большинство движений распознавалось намного лучше случайного угадывания. Хуже всего различались движения левой рукой и ногами, то есть тех областей, которые пластина почти не покрывала.
Главной находкой оказалось то, что активность мозга при совмещенных попытках отличается от активности при отдельных. Часть электродов откликалась и на речь, и на жест, и нейросети, обученные только на отдельных словах и жестах, на совмещенных попытках сбивались. В 15-35% случаев они вообще не замечали, что человек что-то пытается сделать. Помогло обучение на смеси отдельных и совмещенных попыток, после чего доля пропусков упала до 1-5%. Кроме того, «речевая» сеть срабатывала, когда человек только жестикулировал, и наоборот, причем у одного участника такие ложные срабатывания доходили до 76%. Когда каждой сети показали примеры «чужих» действий с пометкой «ничего не происходит», ложных срабатываний не осталось.
Отдельно стоит отметить, что системе не нужно видеть все сочетания фраз и жестов. Пары в тестах, ни разу не встречавшиеся при обучении, распознавались так же хорошо, как знакомые. Это обнадеживает, поскольку с ростом словаря перебрать все комбинации будет невозможно.
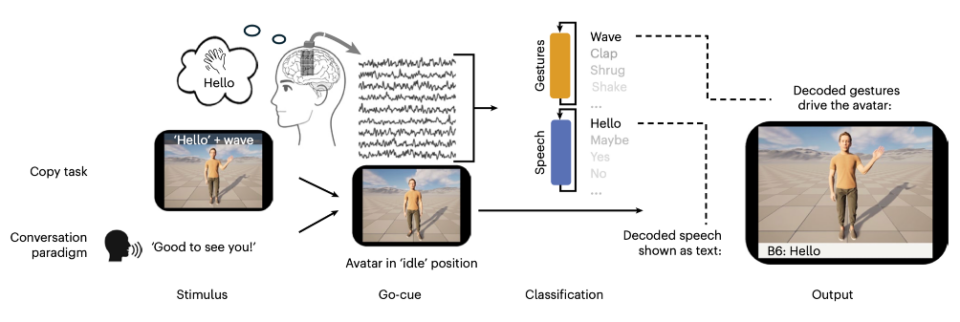
Участник исследования пытается говорить и жестикулировать, расшифрованная речь выводится текстом, а жесты повторяет его персональный аватар. Credit: Brosler et al. / Nature Neuroscience 2026
В реальном времени участник с БАС, выбирая из 10 фраз и 10 жестов, добивался точности 70% для речи и 66% для жестов при одновременных попытках, тогда как случайное угадывание дает лишь около 9%. В коротких диалогах с экспериментатором точность составила 75% и 85%.
Это результаты пока стоит воспринимать как демонстрацию возможности. Одновременные речь и жесты проверены лишь у двух человек. У второго участника с инсультом основные цифры получены на заранее записанных данных, а в реальном времени он имел лишь 9 попыток в диалогах, где и получилась точность 100%. Словарь при этом был крохотный – всего 5 фраз и 4 жеста в 12 заранее выбранных парах.
У участника с БАС, наоборот, перебрали все 100 сочетаний, чтобы нейросеть не могла угадывать жест по сопутствующей фразе. Разброс оценок в ряде тестов очень велик. Аватар также пока не двигается свободно, а проигрывает заготовленную анимацию. Без переобучения точность через дни и месяцы оставалась выше случайной, но у разных участников держалась по-разному, а свежие данные для обучения ее улучшали.
Тем не менее впервые показано, что один имплант способен вернуть парализованному человеку не только слова, но и язык тела.
Текст: Анна Хоружая
Simultaneous speech and gesture decoding for multimodal communication in paralysis by Samantha C. Brosler et al. Nature Neuroscience. Published September 2026